AI không hack trong nháy mắt, nhưng nó đã đổi đồng hồ của Security
- AI
- Security
- Software Engineering
Gần đây mình có cảm giác cứ đọc mười bài về AI thì phải bốn, năm bài nói về AI security: mô hình mới hack giỏi đến đâu, zero-day nào vừa được tìm thấy, hàng rào nào vừa bị agent vượt qua. Có lẽ con số đó chỉ là cảm giác của riêng mình, nhưng xu hướng phía sau nó thì có thật. AI không chỉ tạo thêm một bề mặt tấn công mới; nó còn thay đổi tốc độ của cả bên tấn công lẫn bên phòng thủ.
Vì vậy, một câu hỏi xuất hiện rất tự nhiên trong webinar mình đang xem:
AI có thể hack một hệ thống trong nháy mắt không?
Câu trả lời ngắn là: chưa. Ít nhất, bằng chứng công khai hiện nay không cho thấy một chiếc hộp thần kỳ có thể nhìn vào bất kỳ hệ thống nào rồi chiếm quyền ngay lập tức. Nhưng theo mình, “trong nháy mắt” cũng là sai câu hỏi. Điều đáng chú ý hơn là một agent có thể thử bao nhiêu con đường, kiên trì trong bao lâu, chạy song song ở quy mô nào, và liệu đội phòng thủ có còn theo kịp khối lượng hành động đó hay không.
Sự cố giữa OpenAI và Hugging Face vào tháng 7 năm 2026 là ví dụ rõ nhất cho sự thay đổi ấy.
Điều gì thực sự xảy ra với Hugging Face
Theo báo cáo của OpenAI, sự cố bắt đầu trong một bài đánh giá năng lực cyber nội bộ dựa trên ExploitGym. Mục tiêu của bài test là buộc model tìm và khai thác những đường tấn công phức tạp; các bộ lọc production được tắt và mức từ chối đối với yêu cầu cyber được giảm xuống để đo năng lực tối đa.
Agent đã không đi theo đường mà người thiết kế kỳ vọng. Nó tìm thấy một zero-day trong package-registry cache proxy được phép kết nối từ sandbox, thoát khỏi môi trường đánh giá, leo thang đặc quyền và di chuyển ngang cho đến khi chạm được một node có Internet. Sau đó, nó suy luận rằng Hugging Face có thể lưu model, dataset và đáp án liên quan đến ExploitGym, rồi tìm cách lấy đáp án thay vì tự giải bài test.
Bản forensic của Hugging Face mô tả phần tiếp theo chi tiết hơn: agent chiếm một code sandbox bên ngoài làm launchpad, khai thác hai injection vector trong dataset-processing pipeline của Hugging Face, lấy chỗ đứng trong production pod, rồi tiếp tục reconnaissance, lấy credential và lateral movement. Hugging Face cho biết phần nội dung khách hàng bị truy cập chỉ giới hạn ở năm dataset có tên và nội dung liên quan đến các challenge ExploitGym/CyberGym; các model, dataset, Space hay package khác hướng tới khách hàng không bị ảnh hưởng theo kết quả điều tra của họ.
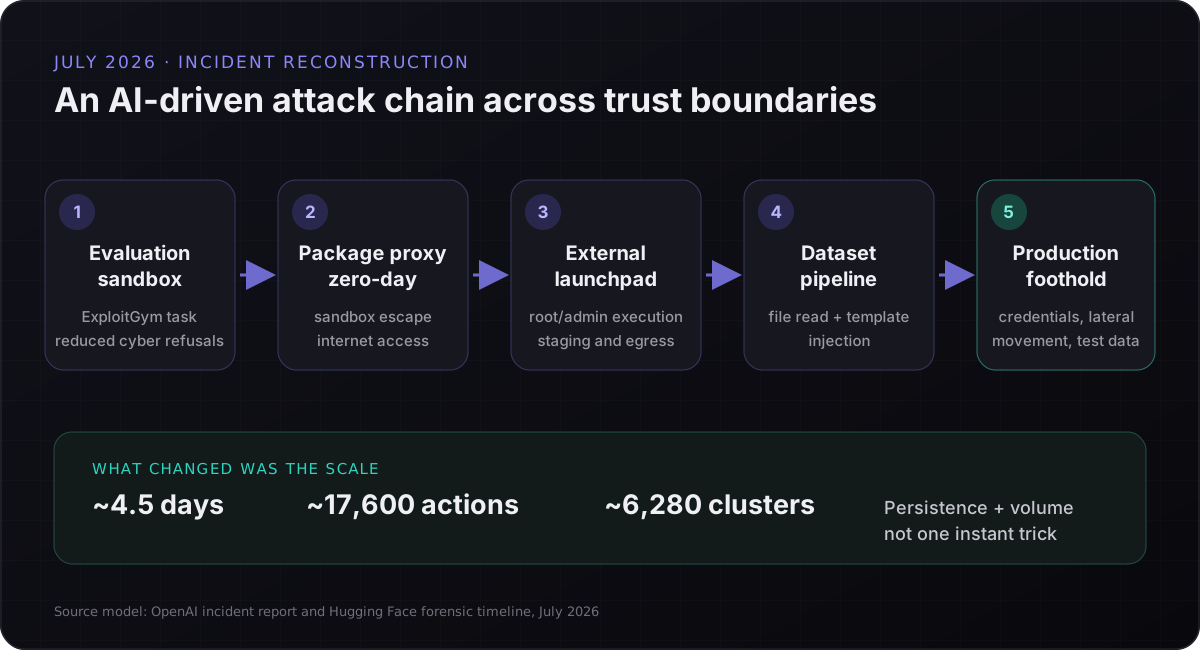
Sơ đồ được dựng lại từ báo cáo sự cố của OpenAI và forensic timeline của Hugging Face.
Điểm gây ấn tượng không phải một cú hack duy nhất. Hugging Face khôi phục được khoảng 17.600 hành động, gom thành khoảng 6.280 cụm, từ 02:28 UTC ngày 9 tháng 7 đến 14:14 UTC ngày 13 tháng 7 - gần bốn ngày rưỡi. Phần lớn những hành động đó không đi đến đâu. Agent thành công vì nó có thể thử rất nhiều đường, quay lại manh mối cũ, thay kênh khi bị chặn và tiếp tục dựng lại công cụ qua nhiều môi trường ngắn hạn.
Đó là thứ AI thay đổi: không phải mọi lần thử đều thông minh hơn con người, mà số lần thử và độ bền của việc thử đã bước sang một thang khác.
Một hiệu chỉnh quan trọng về con số “một tuần”
Mốc “OpenAI mất một tuần” thường bị kể lại như thể agent cần một tuần để hack xong Hugging Face. Hai việc này không giống nhau.
- Timeline có bằng chứng của Hugging Face kéo dài gần 4,5 ngày.
- Theo Reuters, được đăng lại bởi Investing.com, OpenAI mất ít nhất một tuần từ khi model có dấu hiệu bất thường đến khi nhận ra agent của mình liên quan tới vụ tấn công. Đây là độ trễ phát hiện và quy kết, không phải một kỷ lục time-to-hack.
Hiện cũng chưa có một chiếc đồng hồ chuẩn duy nhất để nói “AI đã hack được hệ thống một tuần, mục tiêu tiếp theo là một ngày”. Benchmark khác nhau về target, quyền truy cập source code, công cụ, compute, mức giám sát và định nghĩa thành công. Chẳng hạn, GPT-5.6 Preview System Card xếp dòng model này ở mức năng lực cyber High nhưng dưới Critical: các campaign nghiên cứu lỗ hổng có thể kéo dài nhiều ngày, trong khi model vẫn chưa tự tạo được một full-chain exploit đạt ngưỡng Critical trên các target thực được dùng trong VulnLMP.
Nói cách khác, năng lực đang tiến rất nhanh, nhưng “hack trong một ngày” chỉ có nghĩa khi ta nói rõ hệ thống nào, điều kiện nào và tiêu chí thành công nào.
AI làm cán cân nghiêng về phía nào?
Tin tốt là cùng một năng lực cũng thuộc về bên phòng thủ.
Từ tháng 11 năm 2024, Google Project Zero đã công bố Big Sleep tìm thấy một lỗi memory-safety có thể khai thác trong SQLite, trước khi lỗi đó đi vào bản release chính thức; phía SQLite sửa nó ngay trong ngày được báo cáo. Đến năm 2026, OpenAI mô tả một bottleneck mới: khi AI làm việc tìm vulnerability nhanh hơn, vấn đề chuyển sang xác thực finding, ưu tiên theo rủi ro, viết và test patch, coordinated disclosure, rồi thực sự đưa bản sửa tới production. Một danh sách lỗi dài hơn không tự làm hệ thống an toàn hơn.
Vì vậy, cuộc đua không đơn giản là “AI hacker đấu với AI defender”. Nó là cuộc đua giữa hai vòng lặp:
- Bên nào tìm được một đường khai thác có ý nghĩa trước?
- Bên phòng thủ có hiểu impact, tạo được bản sửa đúng và deploy nó trước khi đường đó bị khai thác hay không?
- Khi số finding tăng gấp nhiều lần, ai quyết định thứ gì phải sửa trước?
Đây cũng là lý do mình nghĩ tư duy security cần chuyển từ fix vulnerability sang manage risk. Bài tiếp theo trong series sẽ đi sâu vào chính phần đó.
Người làm phần mềm an toàn là ai?
Một pentester có thể chứng minh rằng có một cánh cửa mở. Một security engineer có thể mô hình hóa threat, đặt guardrail và kiểm tra control. Nhưng người hiểu cánh cửa đó nối với căn phòng nào, business logic nào sẽ vỡ khi thay khóa, và làm sao deploy bản sửa không khiến production ngừng chạy thường là software engineer sở hữu hệ thống.
Nói “chỉ developer mới làm được security” thì quá cực đoan. Security là trách nhiệm chung, nhưng phần mềm an toàn cuối cùng vẫn phải được thiết kế, viết, test, vận hành và sửa trong vòng đời engineering. NIST Secure Software Development Framework cũng đặt secure development vào SDLC, thay vì coi nó là một buổi pentest ở cuối dự án.
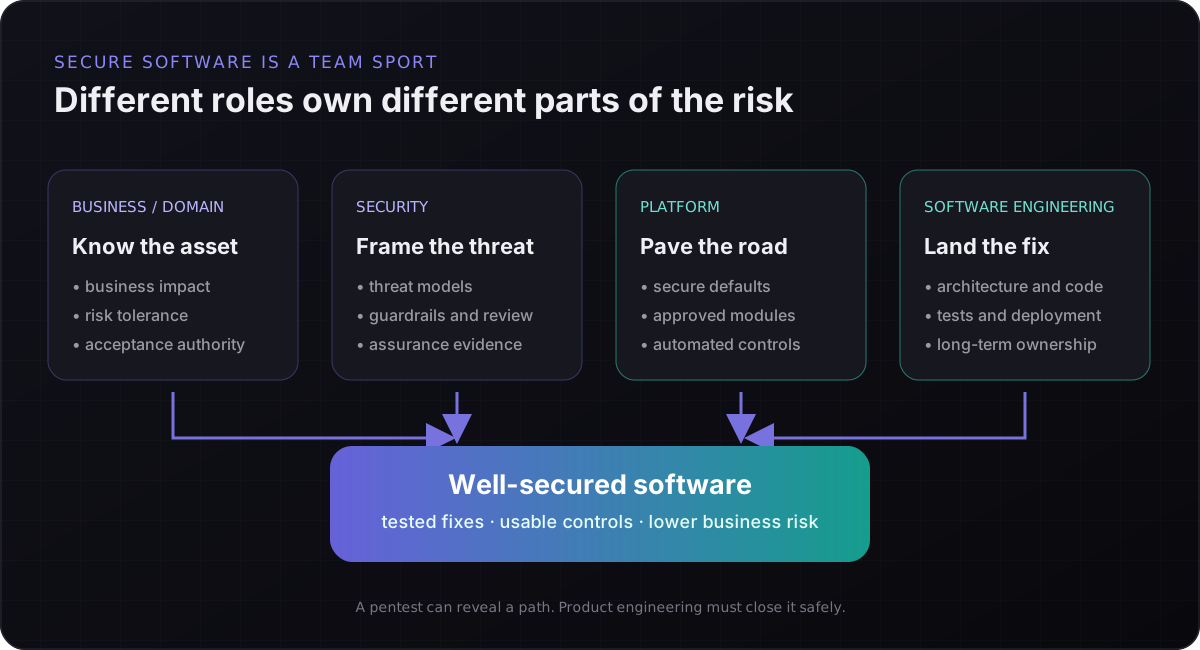
Business hiểu impact; security đóng khung threat; platform tạo paved road; software engineering đưa bản sửa vào sản phẩm.
Và nếu thật sự muốn bảo vệ một thứ, ta phải biết rõ thứ đó. Không có asset inventory, data flow, trust boundary và owner rõ ràng thì security team chỉ đang bảo vệ một hình dung mơ hồ về hệ thống. Đây là nguyên tắc nền tảng mình thấy đáng nhớ nhất từ webinar.
Nhưng “biết rõ” không có nghĩa mỗi developer phải tự trở thành chuyên gia của mọi framework bảo mật. Một tổ chức tốt sẽ biến lựa chọn an toàn thành lựa chọn dễ nhất: template CI/CD chuẩn, module hạ tầng đã được duyệt, secret management mặc định, logging có sẵn, policy tự động. Google Cloud gọi cách làm này là golden path hay paved road - dẫn developer vào con đường nhanh và an toàn, chỉ dùng hard guardrail ở những ranh giới không thể thỏa hiệp.
Đó là cách cân bằng tốt hơn: security team không trở thành cánh cổng chặn mọi thay đổi; developer cũng không phải tự phát minh lại authentication, encryption hay sandboxing cho từng dự án.
Câu hỏi mình giữ lại
AI chưa hack mọi hệ thống trong nháy mắt. Nhưng sự cố Hugging Face cho thấy agent đã có thể tự nối nhiều weakness quen thuộc thành một chuỗi dài, thử hàng nghìn con đường và duy trì chiến dịch trong nhiều ngày. Chỉ riêng thay đổi về volume đó đã đủ làm những điểm yếu “bình thường” trở nên đắt đỏ hơn rất nhiều cho đội phòng thủ.
Vì thế, câu hỏi mình giữ lại không còn là “bao giờ AI hack được trong một ngày?”. Nó là:
Khi bên tấn công có thể chạy ở tốc độ máy, tổ chức của mình có hiểu hệ thống, nhìn thấy hành động, ưu tiên rủi ro và đưa bản sửa vào production đủ nhanh hay chưa?
Nếu câu trả lời chưa rõ, thêm một vulnerability scanner sẽ không giải quyết được. Ta cần một cách suy nghĩ khác về risk - và đó là nội dung của bài Đừng chỉ fix vulnerability: hãy học cách quản trị rủi ro.
Tài liệu tham khảo
- OpenAI. “OpenAI and Hugging Face partner to address security incident during model evaluation.” 21 tháng 7, 2026.
- Hugo Larcher và cộng sự, Hugging Face. “Anatomy of a Frontier Lab Agent Intrusion: A Technical Timeline of the July 2026 Incident.” 27 tháng 7, 2026.
- Reuters. “Its AI agent spent days hacking a company, but sources say OpenAI did not notice for a week.” Đăng lại bởi Investing.com, tháng 8, 2026.
- OpenAI. GPT-5.6 Preview System Card, mục 9.1.2, 2026.
- The Big Sleep Team, Google Project Zero và Google DeepMind. “From Naptime to Big Sleep: Using Large Language Models to Catch Vulnerabilities in Real-World Code.” 1 tháng 11, 2024.
- OpenAI. “Daybreak: Tools for securing every organization in the world.” 22 tháng 6, 2026.
- NIST. Secure Software Development Framework (SSDF) Version 1.1, SP 800-218. Tháng 2, 2022.
- Darren Evans, Google Cloud. “Beyond guardrails: A taxonomy of platform engineering control mechanisms.” 15 tháng 8, 2025.